首页
/
工具详情
PixelRAG 开源平台
PixelRAG (pixelrag.ai) 是由加州大学伯克利分校(UC Berkeley)Sky Computing Lab 团队推出的开源像素级原生视觉检索增强生成(Visual RAG)平台与技术方案。
不同于传统将网页/文档解析为纯文本的 RAG,PixelRAG 采取“用 AI 直接‘看’网页”的思路,保留排版、图表和表格信息。
一、平台介绍与核心机制
1. 核心逻辑
- 跳过解析流程:跳过传统的 HTML 解析与文本提取(无损、无需传统的 OCR/Chunking)。
- 像素空间检索:将网页或文档渲染为截图(Screenshot Tiles),通过多模态视觉嵌入模型建立向量索引,检索时直接在“像素空间”比对。
2. 技术架构
- 渲染层:利用
Playwright CDP或 PDF 渲染器,将页面切割为图像区块(Tiles)。 - 向量化(Embed):使用
Qwen3-VL-Embedding模型提取视觉特征(维度 2048)。 - 检索索引:后端基于
FAISS IVF索引进行海量像素向量检索。
二、主要功能
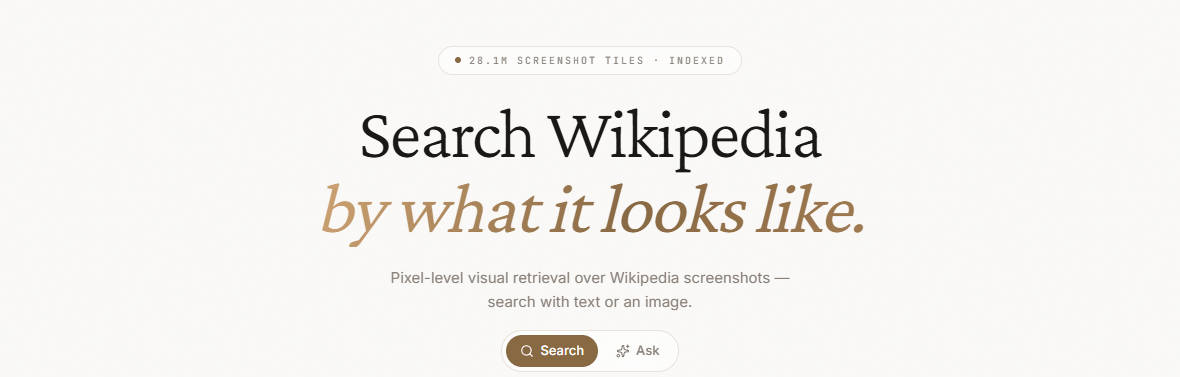
- 像素级文本与图像检索:支持输入“文字查询”或“图片查询”,直接匹配并返回最相关的网页截图碎片。
- 复杂排版与图表保留:完美保留跨列表格、复杂流程图、代码块及 CSS 样式的视觉结构,解决传统文本 RAG 信息丢失的问题。
- 在线体验与维基百科预建索引:官方提供包含 828 万篇 Wikipedia 文章、2810 万张截图分块的轻量在线检索接口与 Demo。
- Claude Code 插件(pixelbrowse):允许 AI 智能体(如 Claude)调用本地截图工具直接“看”网页并总结,无需经过文本抓取。
- 索引与模型解耦:索引库直接存储像素图片。未来升级更新视觉大语言模型(VLM)时无需重新生成向量库,直接更换读取模型即可。
三、适用人群
- AI 开发人员 & 架构师:构建智能客服、文档问答或知识库,需处理大量包含表格、PDF、图表、PPT 或复杂网页的场景。
- Agent / 自动化开发人员:需要为 AI Agent 提供视觉抓取与环境感知能力(配合
Playwright/Claude插件)。 - 科研与学术人员:研究视觉 RAG(Visual RAG)、多模态检索(Multimodal Retrieval)及无 OCR 文档分析。
四、免费与付费情况
- 完全开源与免费:PixelRAG 是一个采用 Apache 2.0 许可证 的开源项目,其核心代码、公用 API 端点及数据集均免费提供。
- 无商业收费:目前无付费订阅或商业定价页面。官方 API 及数据集托管于 Hugging Face,本地部署无需任何软件授权费用。
五、如何使用(快速上手干货)
- 方式 1:在线 API / Web 端直接体验
- 访问 pixelrag.ai,在搜索框输入文本(如 "Periodic table")或上传图片。
- 即可实时检索 2800 万+维基百科截图区块。
- 方式 2:Python 本地渲染与检索
- 安装核心包:
- bash
pip install pixelrag
- 将任意网页渲染为像素切片:
- bash
pixelshot https://en.wikipedia.org/wiki/Python --output ./tiles
- 构建本地私有文档库索引(需安装 index 扩展):
- bash
pip install 'pixelrag[index]'
- 方式 3:为 Claude Code 添加视觉看网功能
- 安装与注册插件:
- bash
pip install pixelrag
claude plugin marketplace add StarTrail-org/PixelRAG
claude plugin install pixelbrowse@pixelrag-plugins
- 终端指令操作:终端中直接让 AI 查看网页截图。
- bash
claude -p "screenshot https://news.ycombinator.com and summarize the top stories"
六、注意事项与使用建议
- 显存与存储需求较集中
- 构建和检索向量依赖 GPU(支持 CUDA 及 Apple Silicon MPS)。
- 如下载全量预建索引(如维基百科索引包),FAISS 索引文件体积较大(约 214 GB),需预留足够硬盘空间。
- 图像 Token 消耗
- 将图像传递给后续的 VLM(视觉大模型,如
GPT-4o,Qwen-VL)进行生成时,图像会占用较多 Token 额度。 - 建议先通过 Tile 降采样或裁剪缩小上下文范围以节省成本。
- 动态网页适配
- 使用
pixelshot截取动态加载(SPA / React)页面时,需确保配置合理的 Playwright 等待时间(Wait time)。 - 防止截取到空白或加载中页面。
暂无评论